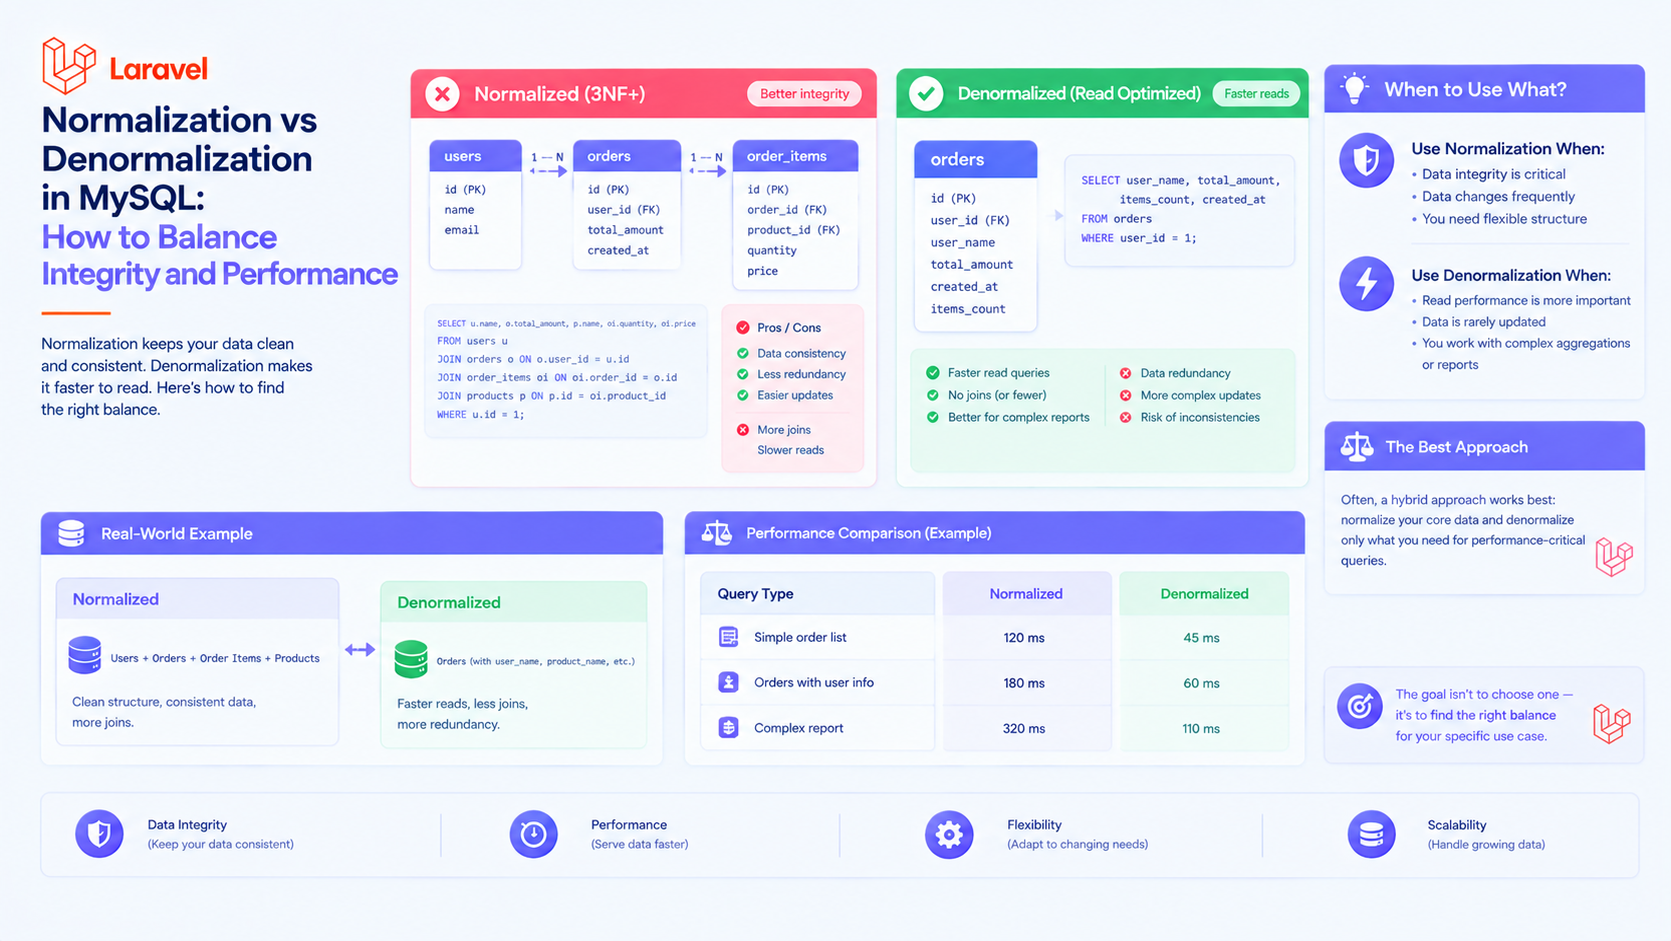
Normalisation vs Dénormalisation dans MySQL : comment équilibrer intégrité et performance
Dans le monde des bases de données relationnelles, en particulier pour des systèmes puissants comme MySQL, deux concepts clés sont constamment pesés par les architectes : la normalisation et la dénormalisation. Ce n'est pas seulement de la théorie aride, mais un choix fondamental qui détermine la performance, l'évolutivité et la fiabilité de votre application. Décomposons ce qu'ils sont, quand utiliser chacun, et comment trouver ce parfait « juste milieu ».
Qu'est-ce que la normalisation ? L'ordre parfait
Imaginez que vous organisez votre archive numérique. Vous ne stockeriez pas tous vos documents dans un seul dossier « Divers ». Vous créereriez une structure : « Travail », « Personnel », « Finances », et à l'intérieur — des sous-dossiers encore plus spécifiques. La normalisation dans MySQL est le même processus, mais pour les données.
La normalisation est le processus d'organisation des données dans une base de données pour réduire la redondance et améliorer l'intégrité. Elle suit un ensemble de règles appelées « formes normales ».
Objectifs principaux :
- Éliminer les anomalies : Empêcher les situations où la mise à jour, la suppression ou l'insertion de données conduit à une incohérence (par exemple, mettre à jour l'adresse d'un utilisateur à un endroit ne devrait pas nécessiter de la modifier dans une douzaine d'autres enregistrements).
- Réduire la redondance : Les données sont stockées en une seule instance. Le nom d'un pays n'est pas stocké dans chaque ligne d'adresse mais dans une table countries séparée, référencée via une clé étrangère.
- Garantir l'intégrité des données : L'utilisation de clés étrangères (FOREIGN KEY) garantit que vous ne pouvez pas référencer un enregistrement inexistant.
Niveaux de normalisation : du chaos à l'ordre
La normalisation est un processus étape par étape. Chaque forme normale suivante inclut les exigences de la précédente.
1NF (Première forme normale) : Atomicité des données
- Règle : Toutes les valeurs dans les colonnes doivent être atomiques (indivisibles).
- Interdit : Les tableaux, listes et autres valeurs composites dans une seule cellule.
Exemple de violation de la 1NF : Une table orders avec un champ products : « Laptop, Souris, Clavier »
Exemple de conformité à la 1NF : Créez une table order_items séparée :
2NF (Deuxième forme normale) : Absence de dépendances partielles
- Règle : La table doit être en 1NF, et chaque attribut non-clé doit dépendre fonctionnellement de l'ensemble de la clé primaire.
- Résout les problèmes : Lorsque la clé primaire est composite et que certains champs dépendent uniquement d'une partie de cette clé.
Exemple de violation de la 2NF :
Ici, product_name dépend uniquement de product_id, et non de la paire entière (order_id, product_id).
Exemple de conformité à la 2NF :
3NF (Troisième forme normale) : Absence de dépendances transitives
- Règle : La table doit être en 2NF, et il ne doit pas y avoir de dépendances entre les attributs non-clés (c'est-à-dire que tous les attributs non-clés doivent dépendre uniquement de la clé primaire).
- Résout les problèmes : Lorsque changer un champ nécessite d'en changer un autre.
Exemple de violation de la 3NF :
Ici, country_name dépend de country_id, et non directement de user_id.
Exemple de conformité à la 3NF :
BCNF (Forme normale de Boyce-Codd) :
- 3NF renforcée : Chaque déterminant (un attribut qui en détermine fonctionnellement un autre) doit être une clé candidate (une clé primaire potentielle).
- Résout les cas rares de clés candidates qui se chevauchent.
La normalisation dans Laravel : une implémentation pratique
Voyons comment fonctionne une structure normalisée dans Laravel à l'aide d'un exemple de blog.
Migrations pour un schéma normalisé :
Modèles Eloquent avec relations :
Qu'est-ce que la dénormalisation ? Un compromis conscient pour la vitesse
Imaginez maintenant que vous devez générer un rapport récapitulatif à partir de tous vos dossiers chaque seconde. Naviguer à travers des dizaines de sous-dossiers devient coûteux. Vous créez un seul dossier « Rapports prêts » où vous pré-stockez des copies des documents nécessaires. C'est la dénormalisation.
La dénormalisation est l'introduction intentionnelle de redondance dans une structure de base de données en combinant des tables ou en ajoutant des champs calculés pour améliorer les performances des opérations de lecture.
Objectifs principaux :
- Accélérer les requêtes : Réduire le nombre de JOINs et la complexité des requêtes.
- Simplifier le schéma : Les requêtes deviennent plus faciles à comprendre et à écrire.
Exemple de dénormalisation dans Laravel :
Supposons que nous devons souvent afficher une liste de posts avec le nom de l'auteur. Au lieu de JOINdre les tables posts et users à chaque fois, nous pouvons ajouter un champ author_name directement à la table posts.
- Table posts (dénormalisée) :
Maintenant, la requête SELECT title, author_name FROM posts s'exécute instantanément.
Un autre exemple : mettre en cache les données agrégées
Disons que nous devons fréquemment afficher le nombre de posts d'un utilisateur. Dans un schéma normalisé, nous ferions un COUNT() à chaque fois.
Approche dénormalisée — nous ajoutons un champ posts_count :
Avantages de la dénormalisation : ✅ Haute vitesse pour les opérations de lecture (SELECT). ✅ Requêtes simplifiées, charge CPU réduite grâce à moins de JOINs.
Inconvénients de la dénormalisation : ❌ Redondance des données : Plus d'espace disque est utilisé. ❌ Risque d'incohérence : Si un utilisateur change son nom, nous devons nous rappeler de le mettre à jour dans tous les posts du champ author_name. Cela complique la logique de l'application. ❌ Opérations d'écriture plus complexes (INSERT/UPDATE/DELETE) : Elles deviennent plus lentes car les données doivent être modifiées à plusieurs endroits.
Alors que devriez-vous choisir ? Une stratégie hybride
En pratique, les formes pures sont rares. Les professionnels utilisent une approche hybride basée sur des exigences spécifiques.
1. Commencez par la normalisation Commencez toujours votre conception par un schéma normalisé (au moins jusqu'à la 3NF). C'est votre « source unique de vérité », garantissant l'intégrité des données pendant le développement et à travers tous les changements.
2. Dénormalisez consciemment et spécifiquement en fonction des métriques Ne dénormalisez pas « au cas où ». Faites-le uniquement lorsque vous rencontrez de réels problèmes de performance. Utilisez la surveillance et EXPLAIN ANALYZE dans MySQL pour trouver les goulots d'étranglement — les requêtes les plus lentes avec un grand nombre de JOINs.
Scénarios typiques de dénormalisation dans MySQL/Laravel :
- Données agrégées : Ajout de champs comme total_likes, order_summary à une table parente pour éviter de calculer SUM() ou COUNT() sur des millions d'enregistrements à chaque fois.
- Tables de reporting larges : Création d'une table ou vue dénormalisée séparée spécifiquement pour les rapports complexes exécutés peu fréquemment.
- Services à forte lecture : Pour les parties de l'application où la vitesse de lecture est critique (par exemple, un fil d'actualité), vous pouvez sacrifier une intégrité stricte pour la réactivité.
- Compteurs : posts_count, comments_count, likes_count.
- Mise en cache des calculs : reading_time, search_index.
3. Gérez la cohérence dans Laravel Si vous choisissez de dénormaliser, vous devez garantir la cohérence des données. Voici les principales méthodes dans Laravel :
- Événements de modèle/Observers : Configurez des observers pour mettre à jour automatiquement les données dénormalisées dans les tables liées lorsque les données primaires changent.
- Transactions de base de données : Garantissez des mises à jour atomiques dans une seule transaction.
- Files d'attente : Pour les mises à jour en arrière-plan de données non critiques.
Conclusion
La normalisation et la dénormalisation ne sont pas des ennemis mais deux outils dans l'arsenal d'un développeur.
- La normalisation concerne l'intégrité et la fiabilité.
- La dénormalisation concerne la performance et la vitesse de lecture.
Dans Laravel, cet équilibre est particulièrement important grâce au puissant ORM Eloquent. Commencez par un schéma propre et normalisé, utilisez le chargement anticipé pour optimiser les requêtes, et n'ajoutez des champs dénormalisés que lorsque c'est vraiment nécessaire, en garantissant toujours leur cohérence grâce aux mécanismes de Laravel.
Mesurez d'abord, optimisez ensuite — et votre application évoluera efficacement !