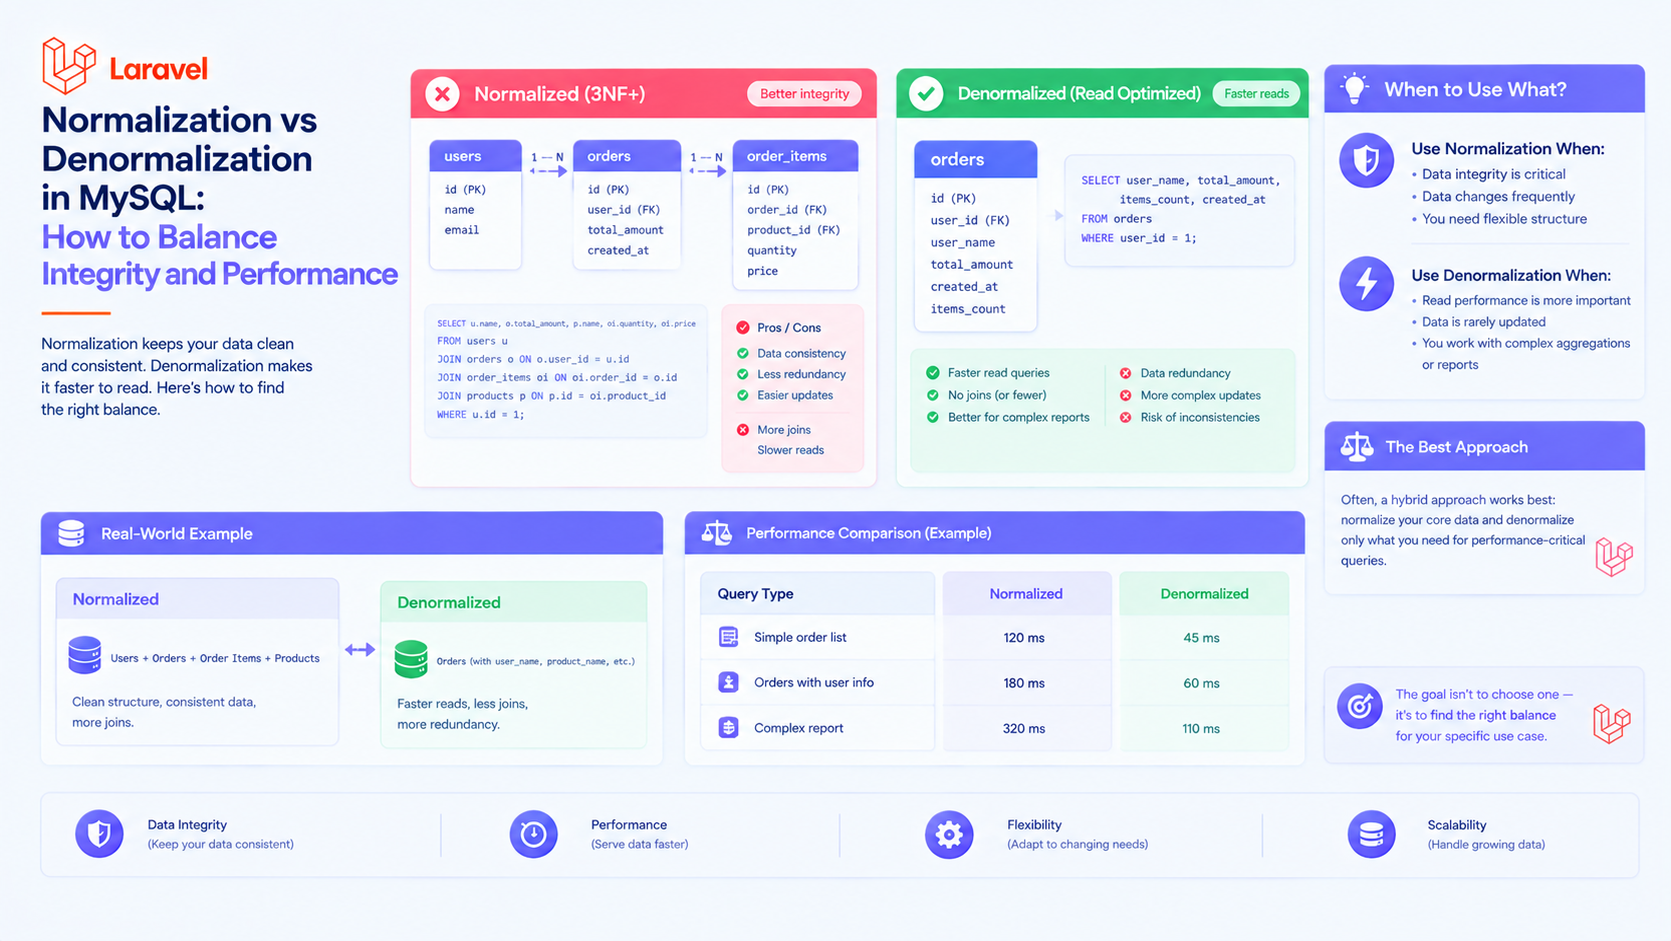
Normalización vs Desnormalización en MySQL: cómo equilibrar integridad y rendimiento
En el mundo de las bases de datos relacionales, especialmente para sistemas potentes como MySQL, dos conceptos clave son constantemente sopesados por los arquitectos: la normalización y la desnormalización. No es solo teoría árida, sino una elección fundamental que determina el rendimiento, la escalabilidad y la fiabilidad de tu aplicación. Desglosemos qué son, cuándo usar cada uno y cómo encontrar ese perfecto «punto medio».
¿Qué es la normalización? El orden perfecto
Imagina que estás organizando tu archivo digital. No almacenarías todos tus documentos en una única carpeta «Varios». Crearías una estructura: «Trabajo», «Personal», «Finanzas», y dentro de ellas — subcarpetas aún más específicas. La normalización en MySQL es el mismo proceso, pero para los datos.
La normalización es el proceso de organizar datos en una base de datos para reducir la redundancia y mejorar la integridad. Sigue un conjunto de reglas llamadas «formas normales».
Objetivos principales:
- Eliminar anomalías: Prevenir situaciones donde actualizar, eliminar o insertar datos conduce a inconsistencias (por ejemplo, actualizar la dirección de un usuario en un lugar no debería requerir cambiarla en una docena de otros registros).
- Reducir la redundancia: Los datos se almacenan en una única instancia. El nombre de un país no se almacena en cada fila de dirección sino en una tabla countries separada, referenciada mediante una clave foránea.
- Garantizar la integridad de los datos: El uso de claves foráneas (FOREIGN KEY) garantiza que no puedas referenciar un registro inexistente.
Niveles de normalización: del caos al orden
La normalización es un proceso paso a paso. Cada forma normal posterior incluye los requisitos de la anterior.
1NF (Primera forma normal): Atomicidad de los datos
- Regla: Todos los valores en las columnas deben ser atómicos (indivisibles).
- Prohíbe: Arrays, listas y otros valores compuestos en una sola celda.
Ejemplo de violación de 1NF: Una tabla orders con un campo products: «Laptop, Ratón, Teclado»
Ejemplo de conformidad con 1NF: Crear una tabla order_items separada:
2NF (Segunda forma normal): Sin dependencias parciales
- Regla: La tabla debe estar en 1NF, y cada atributo no clave debe depender funcionalmente de toda la clave primaria.
- Resuelve problemas: Cuando la clave primaria es compuesta y algunos campos dependen solo de una parte de esa clave.
Ejemplo de violación de 2NF:
Aquí, product_name depende solo de product_id, no de todo el par (order_id, product_id).
Ejemplo de conformidad con 2NF:
3NF (Tercera forma normal): Sin dependencias transitivas
- Regla: La tabla debe estar en 2NF, y no debe haber dependencias entre atributos no clave (es decir, todos los atributos no clave deben depender solo de la clave primaria).
- Resuelve problemas: Cuando cambiar un campo requiere cambiar otro.
Ejemplo de violación de 3NF:
Aquí, country_name depende de country_id, no directamente de user_id.
Ejemplo de conformidad con 3NF:
BCNF (Forma normal de Boyce-Codd):
- 3NF reforzada: Cada determinante (un atributo que determina funcionalmente a otro) debe ser una clave candidata (una clave primaria potencial).
- Resuelve casos raros de claves candidatas superpuestas.
Normalización en Laravel: una implementación práctica
Veamos cómo funciona una estructura normalizada en Laravel usando un ejemplo de blog.
Migraciones para un esquema normalizado:
Modelos Eloquent con relaciones:
¿Qué es la desnormalización? Un compromiso consciente por la velocidad
Ahora imagina que necesitas generar un informe resumen de todas tus carpetas cada segundo. Navegar por docenas de subcarpetas se vuelve costoso. Creas una única carpeta «Informes listos» donde prealmacenas copias de los documentos necesarios. Esto es la desnormalización.
La desnormalización es la introducción intencional de redundancia en una estructura de base de datos mediante la combinación de tablas o la adición de campos calculados para mejorar el rendimiento de las operaciones de lectura.
Objetivos principales:
- Acelerar las consultas: Reducir el número de JOINs y la complejidad de las consultas.
- Simplificar el esquema: Las consultas se vuelven más fáciles de entender y escribir.
Ejemplo de desnormalización en Laravel:
Supongamos que a menudo necesitamos mostrar una lista de posts junto con el nombre del autor. En lugar de JOINear las tablas posts y users cada vez, podemos añadir un campo author_name directamente a la tabla posts.
- Tabla posts (desnormalizada):
Ahora la consulta SELECT title, author_name FROM posts se ejecuta instantáneamente.
Otro ejemplo: almacenar en caché datos agregados
Digamos que frecuentemente necesitamos mostrar el número de posts de un usuario. En un esquema normalizado, haríamos un COUNT() cada vez.
Enfoque desnormalizado — añadimos un campo posts_count:
Ventajas de la desnormalización: ✅ Alta velocidad para operaciones de lectura (SELECT). ✅ Consultas simplificadas, carga de CPU reducida gracias a menos JOINs.
Desventajas de la desnormalización: ❌ Redundancia de datos: Se utiliza más espacio en disco. ❌ Riesgo de inconsistencia: Si un usuario cambia su nombre, debemos recordar actualizarlo en todos los posts en el campo author_name. Esto complica la lógica de la aplicación. ❌ Operaciones de escritura más complejas (INSERT/UPDATE/DELETE): Se vuelven más lentas porque los datos deben modificarse en múltiples lugares.
Entonces, ¿qué deberías elegir? Una estrategia híbrida
En la práctica, las formas puras son raras. Los profesionales utilizan un enfoque híbrido basado en requisitos específicos.
1. Comienza con la normalización Siempre comienza tu diseño con un esquema normalizado (al menos hasta 3NF). Esta es tu «única fuente de verdad», que garantiza la integridad de los datos durante el desarrollo y a través de cualquier cambio.
2. Desnormaliza consciente y específicamente basándote en métricas No desnormalices «por si acaso». Hazlo solo cuando encuentres problemas de rendimiento reales. Usa monitoreo y EXPLAIN ANALYZE en MySQL para encontrar cuellos de botella — las consultas más lentas con un gran número de JOINs.
Escenarios típicos para la desnormalización en MySQL/Laravel:
- Datos agregados: Añadir campos como total_likes, order_summary a una tabla padre para evitar calcular SUM() o COUNT() sobre millones de registros cada vez.
- Tablas de informes anchas: Crear una tabla o vista desnormalizada separada específicamente para informes complejos que se ejecutan con poca frecuencia.
- Servicios con mucha lectura: Para las partes de la aplicación donde la velocidad de lectura es crítica (por ejemplo, un feed de noticias), puedes sacrificar la integridad estricta por la capacidad de respuesta.
- Contadores: posts_count, comments_count, likes_count.
- Caché de cálculos: reading_time, search_index.
3. Gestiona la consistencia en Laravel Si eliges desnormalizar, debes garantizar la consistencia de los datos. Aquí están los métodos principales en Laravel:
- Eventos del modelo/Observers: Configura observers para actualizar automáticamente los datos desnormalizados en tablas relacionadas cuando los datos primarios cambian.
- Transacciones de base de datos: Garantiza actualizaciones atómicas dentro de una sola transacción.
- Colas: Para actualizaciones en segundo plano de datos no críticos.
Conclusión
La normalización y la desnormalización no son enemigas sino dos herramientas en el arsenal de un desarrollador.
- La normalización se trata de integridad y fiabilidad.
- La desnormalización se trata de rendimiento y velocidad de lectura.
En Laravel, este equilibrio es especialmente importante gracias al potente ORM Eloquent. Comienza con un esquema limpio y normalizado, usa la carga anticipada para optimizar las consultas, y añade campos desnormalizados solo cuando sea realmente necesario, garantizando siempre su consistencia a través de los mecanismos de Laravel.
¡Mide primero, luego optimiza — y tu aplicación escalará eficientemente!